 blank
M6里最重要的设计变化,靠的是台积电这套新工艺。
endif; ? 图片来源: Apple xml encoding="utf-8" ?我们自己评测新款 Mac mini 时,分析的是 M5 Pro 版本的性能和性价比,但这颗芯片从春天起就已经在卖了。更值得看的是 M6。它是用台积电 2nm 工艺做的新一代处理器,架构上也有几处值得注意的改动。我们的德国姊妹站 Macwelt 评测了这款机型,发现它比预览用的、搭载 M4 的 Mac mini 提升很大。
芯片上市已经两三周,技术拆解也开始出来了,谈的是更细的架构细节。(我们比较喜欢的两篇来自 Geekerwan,以及 High Yield / SemiAnalysis。)从这些拆解看,这颗处理器有一批新的改进,主要来自台积电的新 2nm 工艺,以及它带来的更高密度。下面是我们了解到的部分内容。
2nm 带来了什么
和 iPhone 18 Pro、iPhone Duo 上的 A20 Pro 一样,M6 是苹果第一批采用台积电新 2nm 制程的芯片,也是全球最早一批量产的 2nm 芯片之一。
新制程不太好直观理解。简单说,这套 2nm 工艺的特征尺寸更小,栅极、晶体管、电阻这类结构都更小,同样的逻辑电路和内存可以塞进更小的面积。你可以拿它把芯片做小,也可以在同样面积里塞进更多东西。
到了 M6 上,苹果因此能增加核心数量、加入新功能,芯片反而比 M5 略小一点。M6 估计大约 142 平方毫米,M5 是 157 平方毫米。除了 119 平方毫米的 M1,M6 是目前 M 系列里最小的一颗。
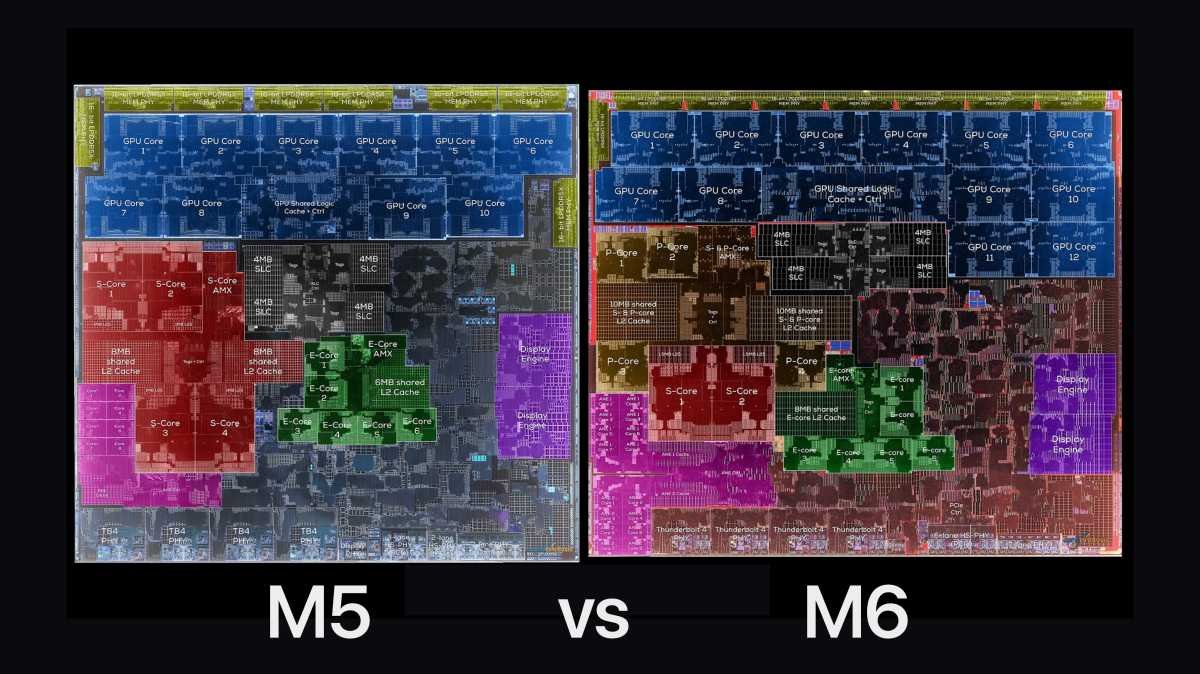 核心数量和缓存都增加了,M6 却比 M5 略小,靠的是台积电 2nm 工艺。
新制程带来的不只是更小、更密的电路。它还换上了一种新晶体管,GAAFET(全环绕栅极场效应晶体管),取代原来的 FinFET。栅极材料被四面围住,FinFET 只有三面。漏电更少,电气特性也更稳,所以可以在更低功耗、更高主频下运行。
CPU 改动很大
到了 M5,苹果把性能核改叫“超级核”。M5 Pro 和 Max 同时用了新的超级核,以及新的中端性能核。A18 Pro 这类芯片则同时有超级核和能效核。
M6 是苹果第一颗用上三种 CPU 核心设计的处理器:2 个超级核、4 个性能核、6 个能效核。这么做的不是只有苹果。英特尔 Panther Lake 这一代就是 4-8-4,它自己称为性能核、能效核和低功耗能效核。
这个新的“中间档”性能核面积大约是超级核的一半。速度不如超级核,但比能效核强不少。等于说,苹果拿 M5 那套 4 个超级核加 6 个能效核的配置,把其中 2 个超级核换成了 4 个性能核。这个设计是合理的:多核 CPU 性能提升明显,对芯片面积和单线程性能的影响都不大。
缓存布局在很多地方和 M5 相近。SLC(系统级缓存,整颗 SoC 的组件共用)仍是 16MB。L2 缓存从 M5 的 16MB 提到 20MB,由超级核和性能核共用。现在用它的是 6 个 CPU 核心,不再是 4 个,容量跟着加大说得通。和 M5 一样,超级核还有一点特别:除了这块大的共享 L2,每个超级核自己还有 1.5MB L2。
能效核据说和 A20 Pro 上的一样,本身已经不算弱,但它们有自己单独的 L2 缓存和 AMX 单元(专门用来加速矩阵运算的 CPU 复合单元)。
这是 M6 最根本的变化之一:新的三档 CPU 核心配置,其中 S 核比前几代更强,主频也更高。M7 上大概还会看到这套三档设计。
GPU 是不是在饿带宽?
和 M5 相比,M6 的 GPU 核心多了 2 个,从 10 核变成 12 核。仅这一项,峰值 GPU 计算性能就提高约 20%,主频也略高一点。新核心的几何处理速率更快(对几何复杂的 3D 场景比较重要),但性能提升主要还是来自核心数量和主频。
放到实际应用里,我们难免觉得 GPU 被内存带宽卡住了。M6 的最高内存带宽是 170 GB/秒,但只有 24GB 和 32GB 机型能到这个数,它们用的是 10667 MT/秒的 LPDDR5x。16GB 机型的内存更慢,跑在 9600 MT/秒,带宽和 M5 一样,是 153 GB/秒。
带宽提升不算大,何况还要和 CPU 核心、神经网络引擎一起分。
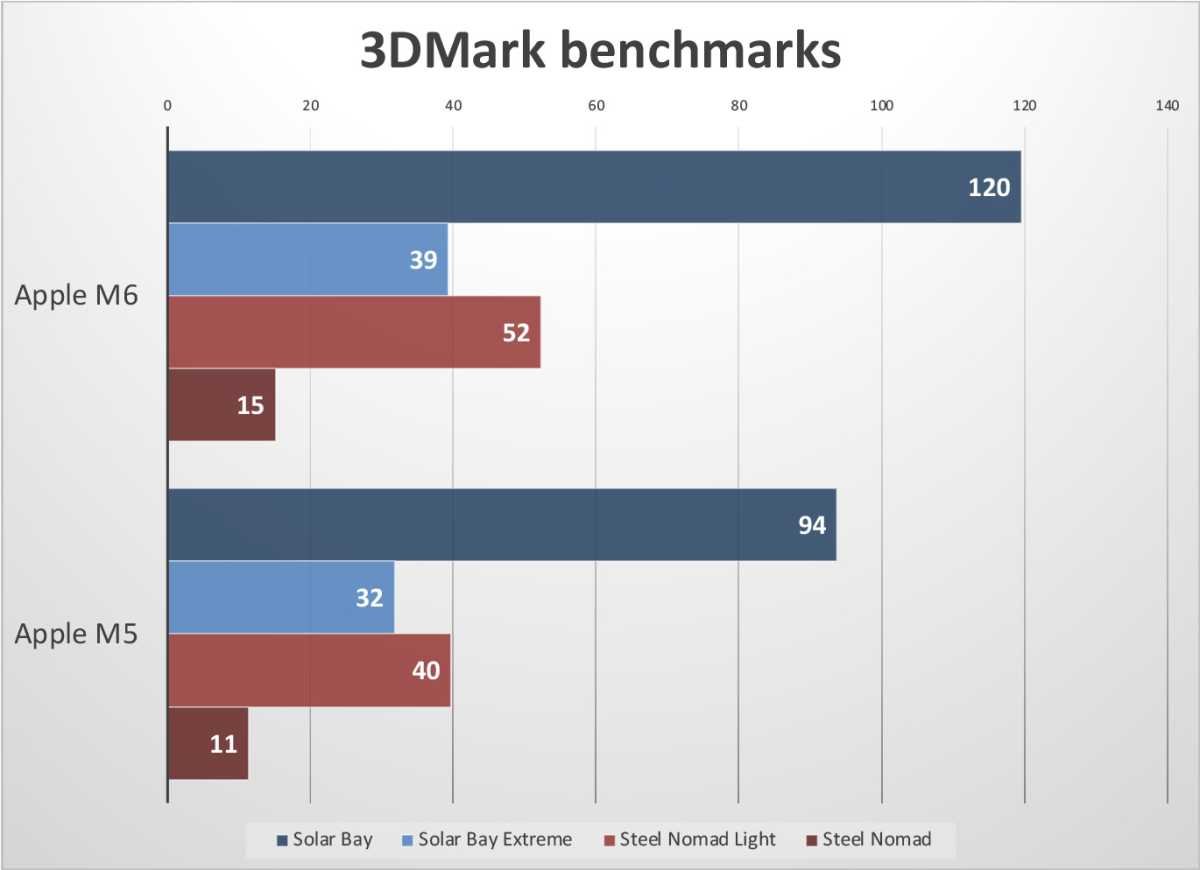
内存带宽只涨了一点,GPU 核心和主频的提升仍让 M6 的 3D 图形性能提高了 20% 或更多。问题也就来了:如果带宽再宽一些,它能快多少?
CPU 核心增加,神经网络引擎核心翻倍,GPU 核心再多 25%,内存带宽只提高 10%,几乎每个环节都可能被带宽限制。M6 的缓存不算少,但 A20 Pro 已经说明,更宽的内存总线能换来多少性能。基础款 M 系列也该跟进了。
神经网络引擎翻倍
说到吃内存的运算,M6 的神经网络引擎和 A20 Pro 一样做了翻倍。严格说,它是两个独立的 16 核神经网络引擎,不是一颗 32 核。每个 16 核簇有自己的缓存,彼此不共享,但整组只有一个控制单元。
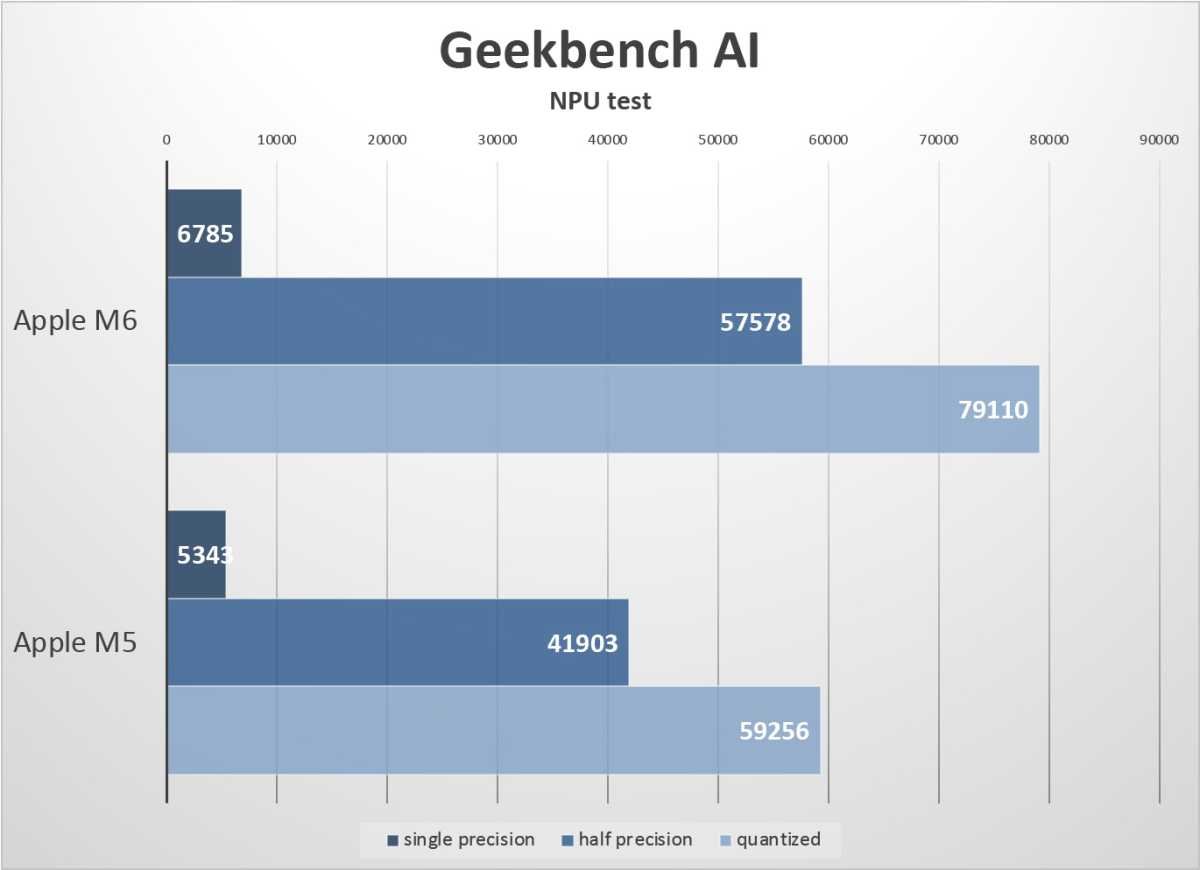
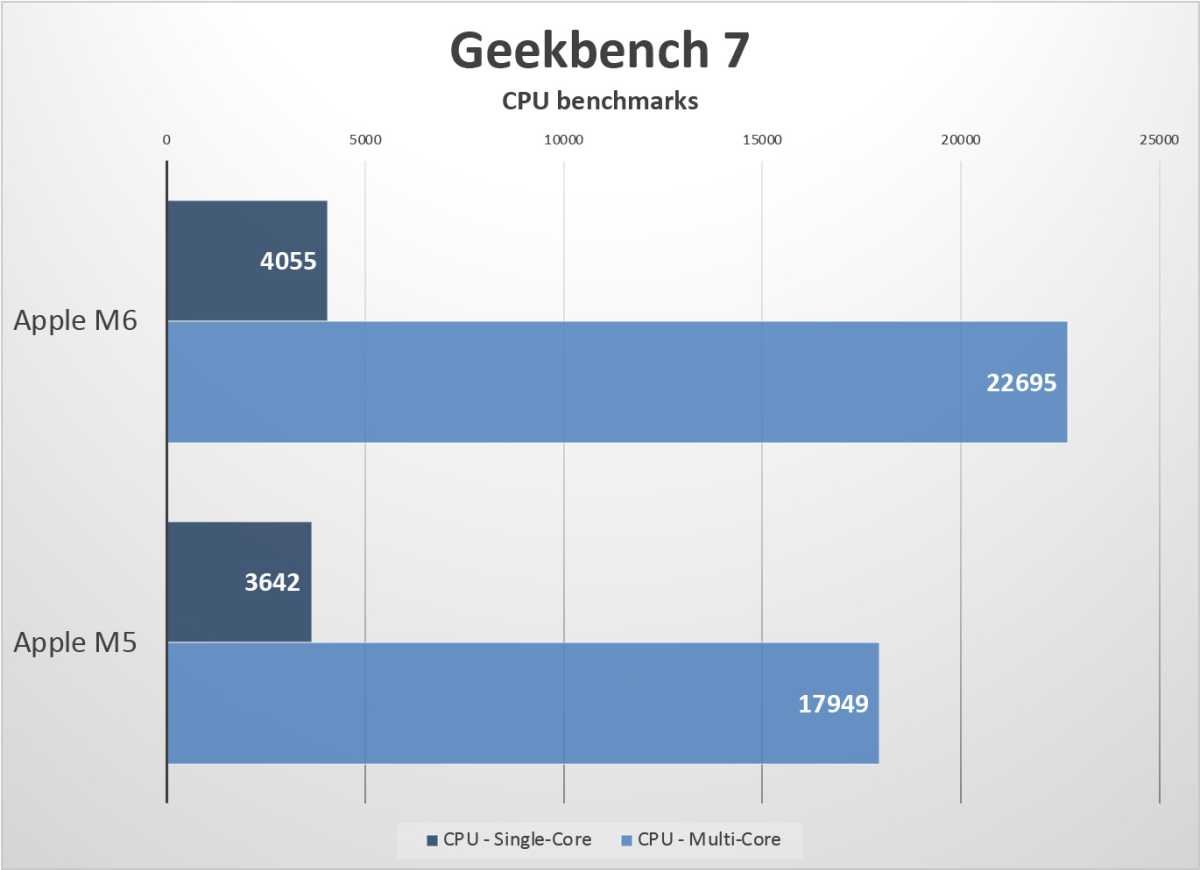
这种 16/16 拆分,和一颗带两倍缓存的 32 核神经网络引擎相比,实际性能差多少,现在还不好判断。能看到的是性能确实上去了:M6 在神经网络引擎上跑量化模型,比 M4 大约快 50%,甚至比 M5 Pro 还快约 20%,尽管内存带宽少不少。
不过得说清楚,核心翻倍不等于性能翻倍,尤其是系统在别的地方已经受限的时候。这里同样要问一句:是不是内存带宽在拖后腿。
M7 只需要干一件事:把内存总线加宽
如果最近的传闻靠谱,M6 会是这一代唯一的芯片。按以往节奏,现在要么已经有 M6 Pro,要么会在 2027 年春天和 M6 Max 一起出现,甚至可能还有 M6 Ultra。然后苹果会在 2027 年秋天用 M7 开启下一代。
传闻却是另一套:M7 被提前,春天出货,M7 Pro/Max 放到秋天。这样一来,M6 就成了这一代仅有的一颗芯片。
据说苹果这么做,主要是为了加快芯片 AI 性能的路线图,原因也不难看出来。M6 的内存接口是 128 位,从 M1 起每一颗基础款 M 系列都是这样。带宽能涨,只是因为 DRAM 颗粒更快。
AI 任务无论跑在神经网络引擎还是 GPU 上,通常都很吃内存。A20 Pro 把内存总线从 64 位加到 96 位、加宽 50% 之后性能提升有多大,我们已经看到了。M 系列也确实到了该这么做的时候。
M7 的 CPU、GPU 和神经网络引擎核心肯定还会有架构上的改进,但没有哪一项比把内存总线加到 192 位或 256 位更关键。用同样的 LPDDR5x,带宽可以到 255 GB/秒或 341 GB/秒,图形、GPU 计算和重负载 AI 任务都会明显更快。
 2507222545
全部评论 0
暂无跟帖